
ProCat Solutions
Abigel.ai Teacher pone a hablar en 26 idiomas y corrige sobre la marcha
Cómo el pipeline de voz de un asistente telefónico se convirtió en profesor: 26 idiomas, niveles A1-B2, escenarios reales, modo KIDS, paquete docente y corrección.
 Teacher· Profesor de idiomas con IA

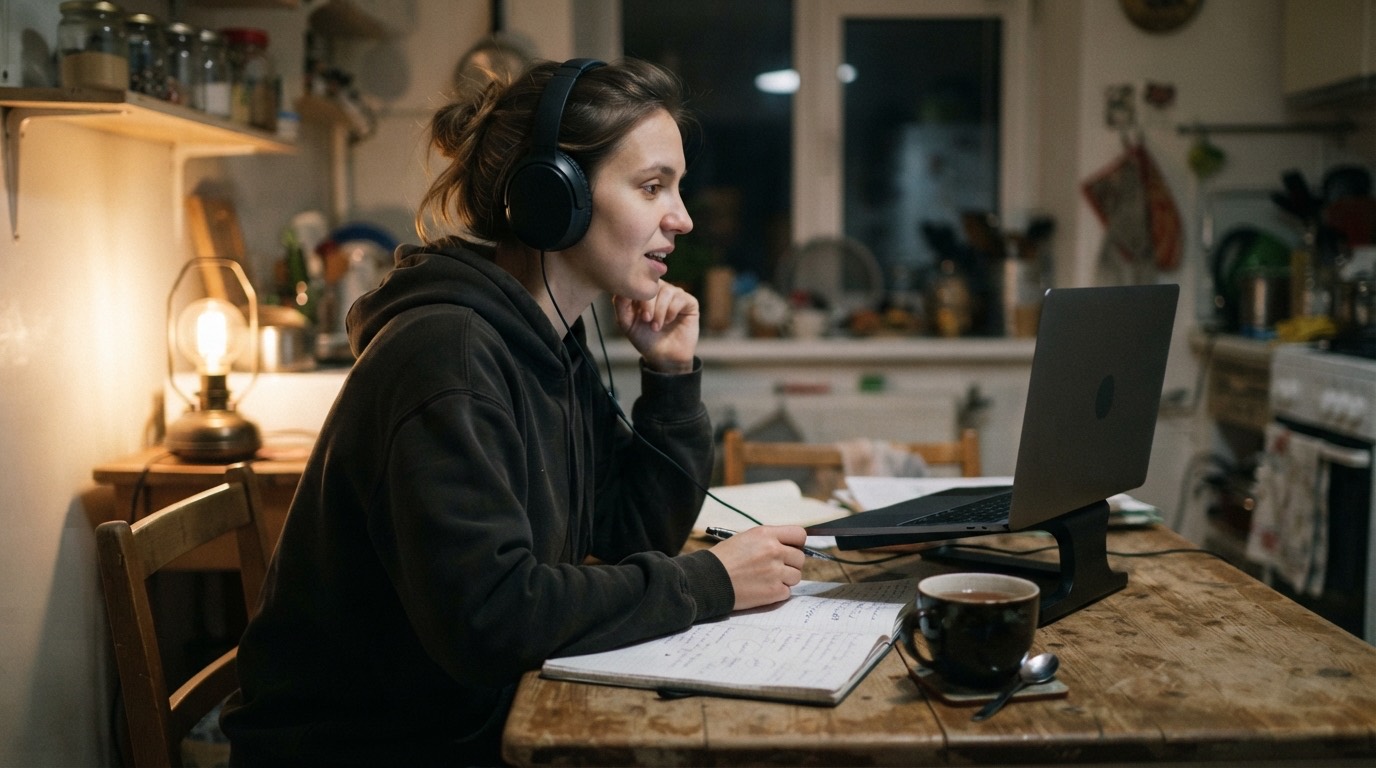
Quien lleva un año estudiando español suele saber leerlo, pero no se atreve a pedir en un restaurante. Abigel.ai Teacher parte de esa observación: a la mayoría de los alumnos de idiomas lo que más les cuesta es lanzarse a hablar, más que la gramática. Con un profesor de IA por voz hay que hablar, en tiempo real, y los errores reciben respuesta inmediata. El producto está disponible en abigel.ai/teacher y es el segundo de nuestro proyecto subvencionado DIMOP Plusz.
26 idiomas, de A1 a B2
Teacher enseña en 26 idiomas y se adapta al nivel del alumno, de A1 a B2. El nivel regula algo más que el vocabulario. En A1 el profesor habla más despacio, con frases más cortas, repregunta a menudo y deja que el alumno pida ayuda en su lengua materna. En B2 la conversación va a ritmo natural, con giros más complejos, y el profesor ayuda menos y corrige más.
El aprendizaje se organiza en escenarios. El catálogo recoge situaciones de la vida real: hacer el check-in en un hotel, pedir cita con el médico, una entrevista de trabajo, una reclamación por una compra, pedir indicaciones, una charla con un vecino. Cada escenario tiene un objetivo que cumplir al final de la conversación, y el profesor interpreta un papel: el recepcionista, el asistente del médico, el entrevistador. En lugar de un examen de vocabulario, el alumno tiene que resolver una situación.
Corrección sobre la marcha
El profesor corrige de dos maneras. Los errores menores (conjugación, orden de las palabras, artículos) los repite bien dentro de su propia respuesta, como haría un buen profesor, sin cortar la conversación. Ante errores mayores o frases incomprensibles se detiene y explica brevemente cuál era el problema.
Al terminar, genera un resumen detallado: las frases del alumno, su versión corregida, los tipos de error recurrentes y algunas expresiones para la próxima sesión. Con el tiempo, los resúmenes forman un diario personal de errores en el que se ve qué ha mejorado y qué no.
Reglas propias para niños
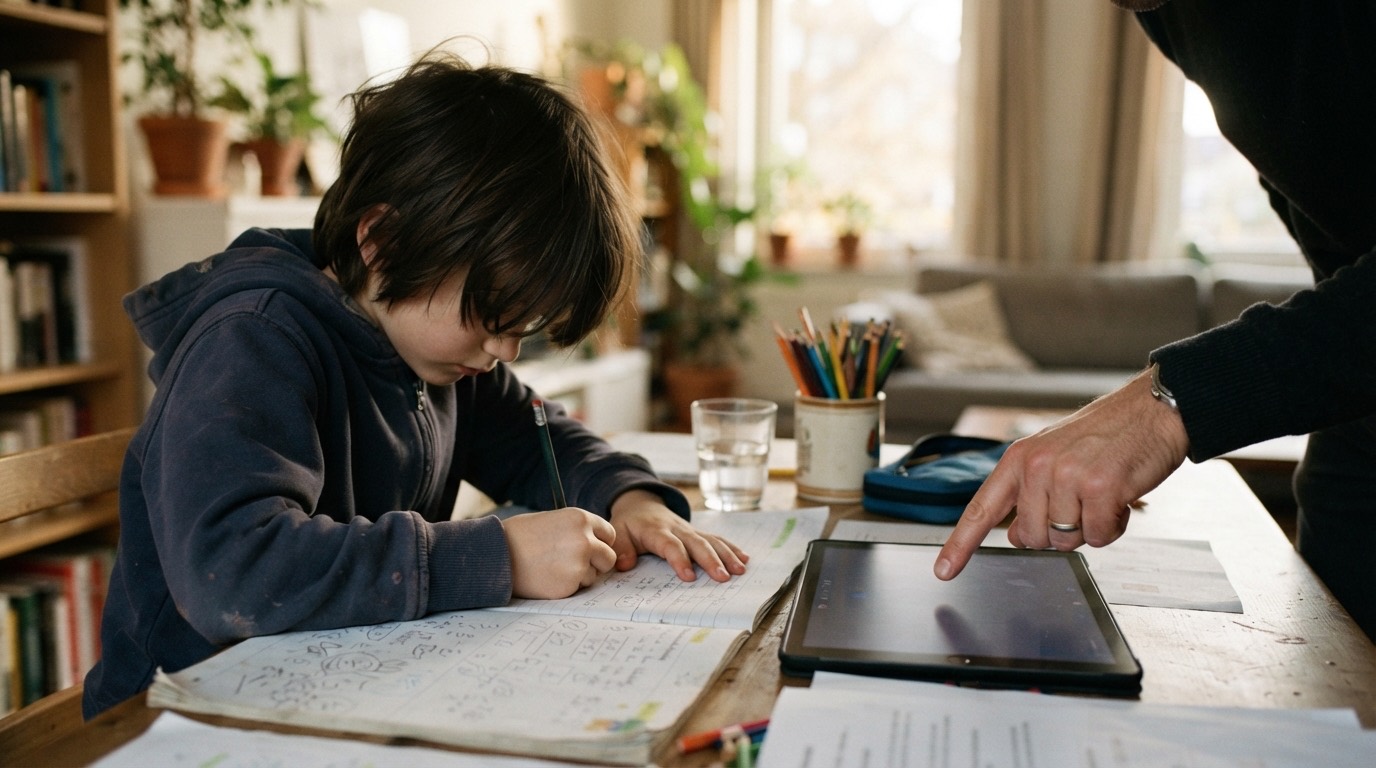
El modo KIDS, pensado para niños, tiene un diseño propio. La voz y el estilo del profesor son más lúdicos, y los escenarios, más cortos y con aire de cuento: una visita al zoo, la búsqueda de un juguete perdido. La respuesta es siempre alentadora; la corrección llega como “también se puede decir así”, nunca como un error. El contenido está estrictamente filtrado: el profesor no se sale del escenario ni habla de temas que los padres no hayan autorizado. Los padres siguen desde su propia cuenta las conversaciones y el progreso del niño.
Deberes y clasificación
En el paquete para profesores de idiomas, un docente puede gestionar a varios alumnos. Puede asignar escenarios como deberes, leer los resúmenes y el diario de errores de las conversaciones de sus alumnos y decidir a partir de ahí en qué centrar la siguiente clase. La clase presencial se mantiene; esto la complementa. La práctica oral es lo más caro de una clase, porque solo puede hablar un alumno a la vez. Aquí se hace en paralelo y sin límite de tiempo.
Dentro de cada grupo, una clasificación muestra el tiempo de práctica y los escenarios completados. A propósito no la basamos en la ausencia de errores, que desanimaría a la gente a hablar. Premia la cantidad de práctica y el progreso.
Del recepcionista al profesor
La mayor ventaja al desarrollar Teacher fue no tener que reconstruir el pipeline de voz. El Virtual Assistant ya contaba con reconocimiento de voz en streaming, un modelo de lenguaje transmitido token a token, síntesis de voz por fragmentos de frase, barge-in (el alumno puede interrumpir), detección del idioma de quien llama y fallback entre varios proveedores. El mismo pipeline corre bajo Teacher. Solo cambia el cliente: navegador y aplicación móvil en lugar de teléfono, WebRTC en lugar de SIP.
Hubo cuatro novedades:
- la capa docente: el modelo de lenguaje recibió un rol de “corrector” independiente, que analiza la frase del alumno antes de responder y pasa los errores de forma estructurada para que lleguen también al resumen;
- el ajuste del reconocimiento de voz a la pronunciación de los alumnos: el recepcionista estaba optimizado para hablantes nativos, mientras que el alumno habla con errores de pronunciación, acento y frases a medias. El sistema tiene que transcribirlo con exactitud, sin suavizarlo, o el profesor no verá el error;
- la gradación por niveles: la longitud, el ritmo y el vocabulario de las respuestas los fija el nivel configurado, y no solo el prompt lo sigue, también la velocidad del TTS;
- el motor de escenarios: los elementos del catálogo son descripciones estructuradas (roles, objetivo, giros esperados, errores típicos) desde las que arranca la conversación, y al final el sistema comprueba si se cumplió el objetivo.
La lección principal para nosotros es que dos productos se apoyan ya en la misma base en tiempo real. El pipeline de voz es infraestructura. Si se mantiene bien separado del caso de uso, el siguiente producto se reduce en gran parte a contenido y reglas.